1. はじめに
近年の推薦システムでは生成型推薦(Generative Recommendation) という設計パラダイムが台頭しつつあります。生成型推薦は単一のモデル構成や推薦手法を指す言葉ではなく、「生成」によって何を達成しようとするかは論文やシステムによって異なっています。
本記事では「ユーザー行動を条件としてアイテム・識別子列・行動列を直接予測する設計」を狭い意味での生成型推薦として扱い、次の二つのテーマを取り上げます。
- Semantic ID などのコード列を自己回帰的に生成して候補アイテムを得る生成型リトリーバル
- ユーザー行動を長い系列として逐次変換・予測する大規模行動系列モデル
なお「LLM を使えば生成型推薦と呼ぶ」というわけでもないため、LLM を生成的ではない用途で推薦システムに組み込んだ例として LLM ベースの ranker モデルも取り上げ、生成型推薦と対比してみます。
まずは従来の産業用推薦がどのようなものなのかを確認した後、それぞれの設計上の狙いを見ていきながら生成型推薦は何を生成しているのかを掴んでいきます。
2. 従来の産業用推薦システム
2.1 two-stage recommender で大規模カタログを扱う
大規模なカタログを持つオンラインサービスでの推薦では次のような two-stage recommender を構成するケースが多いでしょう。
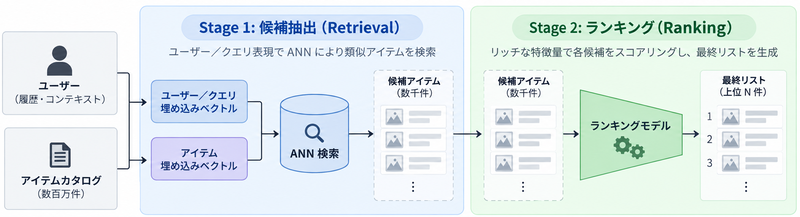
第一段階の候補抽出では数百万件とあるカタログから数千件程度のアイテムに絞り込みます。ここでは全アイテムを1件ずつ精査するわけではなく、クエリとなるアイテムやユーザーの embedding を使って近似近傍探索(ANN: Approximate Nearest Neighbor)によって絞り込みを行います。
第二段階のランキングでは抽出された候補アイテムに対してスコア付けを行います。スコア付けの対象となるアイテムはたかだか数百〜数千件程度のため、ユーザーやアイテムのリッチな特徴量を使ってサービスの KPI を改善するように学習された機械学習モデルによって順位の最適化を行い、最終的にユーザーに提示するアイテムを決定します。
この候補抽出とランキングによる分業は高品質な推薦機能を高速に提供するため、産業用推薦システムでの実用的な構成となっています。
2.2 Two-Tower モデル
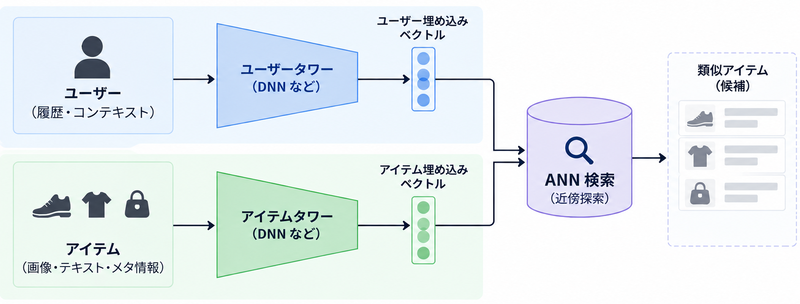
候補抽出の代表的な手法として Two-Tower モデルがあります。Two-Tower モデルはユーザー側の特徴・行動履歴をユーザーベクトル に、アイテムをアイテムベクトル
に別々に変換し、両者の近さをスコアとして扱います。
アイテムベクトルを事前計算できるため、ANNインデックスと組み合わせやすいのが大きな利点です。Two-Tower モデルのユーザータワーを使ってユーザーベクトルをオンラインで計算し、ANN によって全カタログから候補アイテムを取り出すことができるため、この構成は現代の推薦システムにおいて非常に強いベースラインとなっています。
一方、候補抽出でこの分離を成立させるためのトレードオフもあります。
トレードオフ 1: 候補抽出時に相互作用を扱いにくい
ANN を使った候補抽出を行う場合、ユーザーの直近の意図とアイテムの特定属性との細かな相互作用を候補ごとに計算するには様々な工夫が必要になります。ユーザー埋め込みの各次元を通して候補アイテムとの関係性を一定考慮できますが、結局は内積計算で表現できる相互作用に限定されます。
後段のランキングでは交差特徴や Cross-Attention を用いて相互作用を考慮しますが、候補抽出時に同等の相互作用を扱うにはあらかじめ特徴量や表現へ織り込む必要があります。
トレードオフ 2: 計算資源を性能へ変えにくい
Two-Tower モデルを含め、多くの ID 埋め込みを用いる推薦モデルでは学習・推論コストのうち高カーディナリティな ID を Embedding Table から読み出す処理が大きな割合を占めます。この処理は大規模な行列演算よりもメモリ読み出しに律速されやすく、GPU の演算性能を十分に使い切れないことがあります。
そのため MLP などの密なネットワークを大きくしたり計算資源を増やしたりしても、それをそのまま学習スループットやモデル品質の向上へ結び付けることは容易ではありません。Transformer のように、各層でパラメータの大部分を行列演算に使う密なモデルとはスケールのさせ方が異なっています。
言語モデルではモデル規模・学習データ・計算量を増やすと損失が予測可能な形で改善するスケーリング則が観測されてきましたが、推薦でも同じような性質を得られるかは自明ではありません。
生成型推薦のうち行動系列を密なモデルで扱う系統では、モデル・データ・計算量を増やしたときに推薦性能をどこまで伸ばせるかを探る試みでもあります。
3. 生成型推薦とは
3.1 識別型と生成型の違い
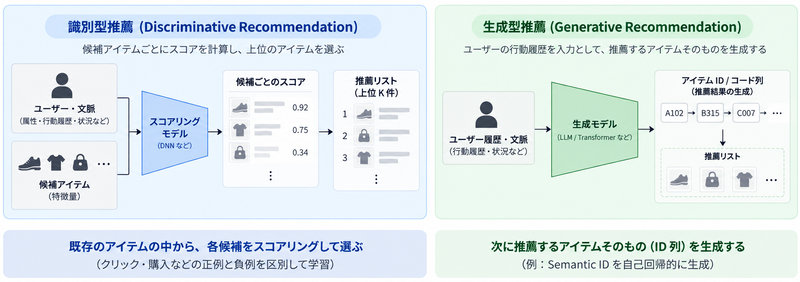
従来の候補抽出やランキングに使われる推薦モデルはユーザーの属性や行動ログ、アイテムの属性などをもとに、候補アイテムごとの関連度やクリック確率をスコアとして出力します。 推薦リストを作る際にはそのスコアを比較して上位のアイテムを選びます。多くのケースでは学習時にはクリックや購入などが観測されたアイテムを正例とし、観測されなかったアイテムから抽出した負例よりも正例を高く評価するように学習します。
このような方式で正例と負例を区別するものは識別型推薦(Discriminative Recommendation)と呼ばれています。*1
これに対し、狭い意味での生成型推薦(Generative Recommendation) は候補アイテムを一つずつ採点するのではなく、ユーザーの行動履歴を入力として次に推薦するアイテムそのものやその識別子列を出力として生成します。 例として、後述する SID 型の生成型リトリーバルではSemantic ID *2 と呼ばれる ID 体系でアイテムを表現し、その ID 列を自己回帰的に生成して候補アイテムを得ます。
3.2 生成型推薦を捉える三つの設計要素
KDD 2026 のチュートリアル*3では「候補アイテムを採点するのではなくユーザー行動を条件としてアイテムや行動を直接生成する推薦システム」を生成型推薦として捉え、その設計を次の三要素で整理しています。
- Tokenization:アイテム・行動・属性をどのようなトークンとして表すか。Semantic ID はこの選択に当たる。
- Architecture:トークン列をどのモデルで処理し、どのように次の出力を生成するか。
- Optimization:次トークン予測、ランキング、強化学習などをどの目的で組み合わせるか。
これは生成型推薦を捉えるための近年の体系的な枠組みの一つです。本記事では既存研究を網羅的に分類するのではなく、この枠組みを手がかりにして SID 型生成リトリーバルと行動系列を系列変換として扱う方式の生成型推薦を取り上げます。
さらに、生成モデルを基盤にしていても直接生成を行わない LLM ベース推薦ランカーを対比対象として置きます。上述の三要素はどの方式にも関係しますが、以下の表では各例で特に違いが現れる設計要素を比較しています。
| 本稿で扱う対象 | 本稿で強調する設計要素 | 本稿での位置付け | 取り上げる手法 |
|---|---|---|---|
| SID 型生成リトリーバル | Tokenization として SID を設計し、そのコード列を生成する | 狭義の生成型推薦 | TIGER*4 PLUM*5 |
| 行動系列を系列変換として扱う推薦 | 長い系列を処理する Architecture と学習・配信を含む Optimization | 狭義の生成型推薦 | HSTU*6 OneRec*7 |
| LLM ベース推薦ランカー | LLM を用いてユーザー表現を獲得し、候補集合のスコアリングを行う | 生成型推薦との対比対象 | LlamaRec*8 GenRec*9 |
この表の行は排他的ではありません。たとえば長期系列を SID で扱う生成型推薦として OneRec と呼ばれる手法がありますが、これは Tokenization と Architecture の工夫を含んでいます。
3.3 SID 型生成リトリーバル
生成型推薦では、アイテムをどのトークンで表すかが Tokenization の設計になります。このパターンは Semantic ID (SID) と呼ばれるアイテム識別子を用いてカタログ内の全アイテムを SID で表現し、そのコード列を生成することで商品の推薦を行います。
Semantic ID とは
通常のアイテム ID は item_12345 のような意味を持たない一つの識別子です。これに対して SID は 1 アイテムを複数の離散コードの組で表します。
たとえば、ある商品 A を (12, 7, 43)、商品 B を (12, 122, 99) のように表します。
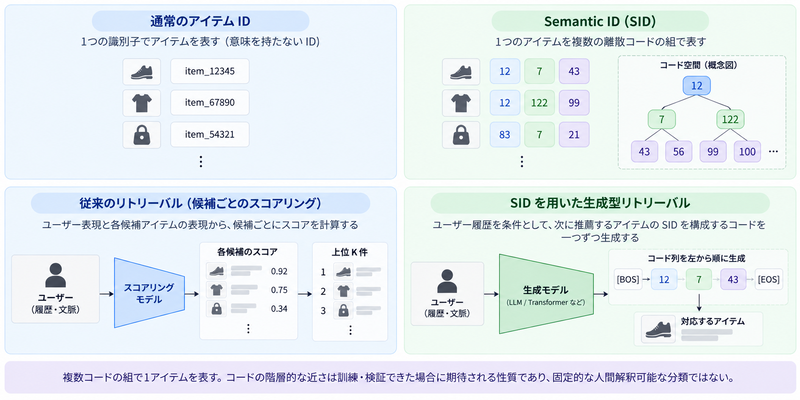
従来のリトリーバルではユーザー表現と各候補アイテムの表現を元にして、候補アイテムごとのスコアを計算します。これに対して SID 型では、ユーザー履歴を条件として「次に推薦するアイテムの SID を構成するコード」を一つずつ出力します。 候補ごとに採点するのではなく、アイテムを表すコード列そのものを出力として生成することが、この系統で「生成型」と呼ばれる理由です。
なぜ SID を使うのか
SID を使う一番の理由は、数千万件以上になるアイテムのカタログをそのまま出力語彙として扱うことを避けるためです。アイテムごとに一つのトークンを割り当てる場合、モデルの出力層にはカタログ中の全アイテムに対応するパラメータが必要になり、また次アイテムの確率分布を計算する際には全アイテムを出力候補として比較することになります。
大規模なサービスでは推薦候補が数千万〜数億件に達することもありますが、この場合、言語モデルの一般的なサブワード語彙数である十数万トークンよりはるかに大きい出力空間を扱うことになります。その結果、出力層のパラメータや計算コストが大きくなるだけでなく、出現頻度の低いアイテムは個別トークンとして十分な学習信号を得にくくなってしまいます。
これに対して SID では、各段の語彙サイズを 、コード長を
とするコード列でアイテムを表し、各段の語彙サイズが全て
の場合に表現可能なコード列は
通りとなります。実在アイテムの数に絞れば全ての組合せを使うわけではありませんが、比較的小さな語彙を組み合わせて非常に大きなアイテム空間を表現できます。
生成時は SID を構成するコード列を左から順に出力していきます。例えばユーザーのコンテキスト を入力として、
[BOS] → "12" → "7" → "43" → [EOS] のようにコード列を出力し、(12, 7, 43) に対応する商品を逆引きします。
このように SID は出力語彙数を減らしながら大規模なアイテム空間を扱えるようにするアイデアですが、以下ではこの SID をどのようにして推薦タスクに適用しているのかを見ていきます。
TIGER (NeurIPS 2023)
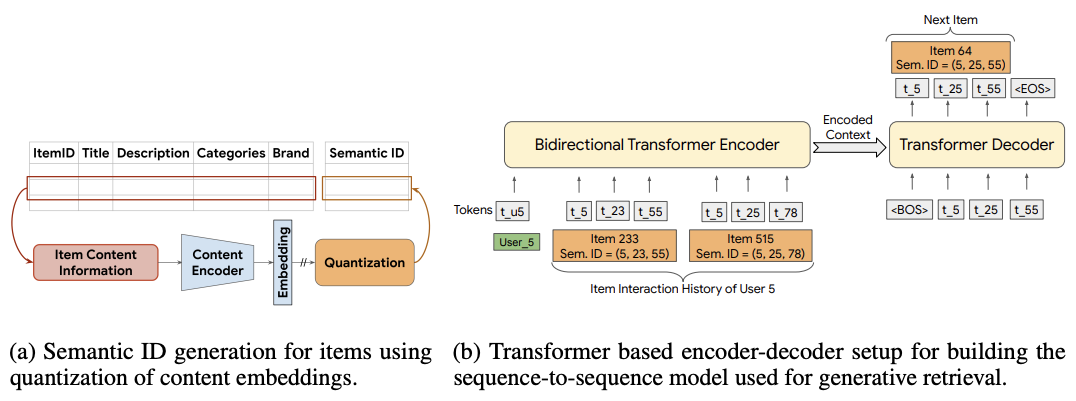
論文: Rajput et al., "Recommender Systems with Generative Retrieval", NeurIPS 2023
TIGER は SID そのものを提案した論文で、SID で学習させた Transformer によって推薦を行う例を示しています。
TIGER ではアイテムのタイトル、価格、ブランド、カテゴリなどのコンテンツ情報から作った埋め込みを Residual Quantized VAE(RQ-VAE)*10 で複数段に量子化して SID を作っています。
RQ-VAE は元の埋め込みに近いコードを一つ選び、そのコードで表し切れなかった差分(残差)を次の段のコードで近似することを繰り返し、粗い近似から細かな近似へと複数のコードを積み重ねます。各コードが人間に解釈可能なものになるとは限りませんが、たとえば「コード 11 を持つアイテムは夏物っぽい」といった具合で、同じコードを共有するアイテムは元のコンテンツ埋め込みにおける近さが反映されることを期待しています。
SID は商品を表すため、TIGER ではユーザーの行動履歴を SID の系列へ置き換えて encoder-decoder 構成の Transformer に入力します。デコーダは前述の通り次アイテムの SID を左から右へ出力します。すなわち、従来の識別型推薦のように候補アイテムを一件ずつ採点するのではなく、12 → 7 → 43 のようなコード列を生成してそれに対応するアイテムをカタログから取得します。
は SID を構成する
番目のコードで、コード列全体が次に推薦するアイテムの識別子となります。
このようにして生成されたコード列の組合せにはカタログに対応しないものも含まれる可能性があるため、TIGER ではビームサーチで複数の SID を生成し、カタログに存在しない SID をフィルタリングして候補を得ます。また、複数アイテムが同じ SID にマッピングされてしまう可能性もあるため、アイテムをユニークにするための追加コードを付けて全アイテムで一意になるようにしています。
TIGER 以後には、SID の作り方や生成器、探索方法を改良・検証する研究が数多く続いています。TIGER 型のパイプラインを構成要素ごとに再実装し、RQ-VAE、SID の長さ、ユーザートークン、制約付き探索といった要素を系統的に検証した論文として GRID*11 が参考になります。
PLUM (WWW 2026)
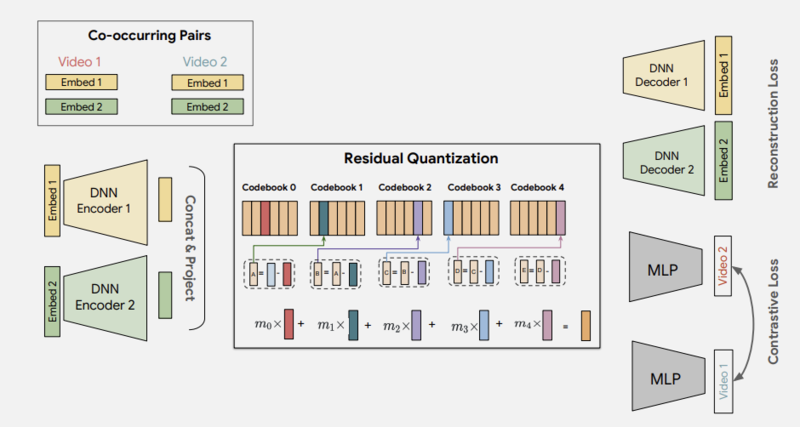
PLUM は YouTube に TIGER の定式化を導入して成果を挙げた例です。PLUM では TIGER で提案された SID を改良して SID-v2 として、より産業用推薦の用途にフィットさせています。
| TIGER の論点 | PLUM の対応 | 狙い |
|---|---|---|
| コンテンツ埋め込みだけで SID を作るため、ユーザー行動の協調信号を反映していない | テキストメタデータ・映像・音声を統合し、動画共起を近づける対照学習を SID の学習に加える | 内容と協調信号の両方を SID へ反映する |
| 各段の codebook が同じ大きさで、使われないコード列が多くなりやすい | 2048 → 1024 → 512 → 256 → ... と段ごとに半減させる |
粗いコードから細かなコードへ情報を割り当て、未使用コード列を減らす |
| 事前学習済み LLM は SID や推薦文脈を扱えない | SID を語彙へ追加し、CPT と SFT で推薦タスクへ適応する | 動画内容・行動文脈を条件に次動画の SID を生成できるようにする |
SID は事前学習済みの LLM(decoder-only Transformer)の語彙として追加し、動画メタデータやユーザー行動系列から構成したプロンプトで Continued Pre-training(CPT) を行います。その後、ユーザー履歴・特徴・現在閲覧中の動画の情報をプロンプトにして、ターゲット SID を生成するよう Supervised Fine-Tuning(SFT)することで、事前学習済みの LLM に対して「ある閲覧履歴を持つユーザーがあるアイテムを消費している場合にはこういう SID を提示すべき」と学習させます。
推論時は SFT した時と同様にユーザーの特徴と閲覧情報を元にしたプロンプトを入力として、次に閲覧すると推測される SID を事前学習済み LLM で逐次的に生成します。
PLUM は実際に YouTube で数十億ユーザー規模のリトリーバルへ展開されており、長尺動画では視聴ユーザー数が +0.07%、Panel CTR が +0.76%、Shorts ではそれぞれ +0.28%、+4.96% 改善したと報告されています。なお、これは既存のリトリーバル手法を完全に置き換えた結果ではなく、既存手法の候補数を増やすパターンと PLUM を併用するパターンでの比較を行った結果である点に注意が必要です。
一方で、SID を作る段階に協調信号や推薦目的をどのように反映するか、また SID の生成尤度だけで最終的なアイテムの関連度をどこまで表せるかは、引き続き重要な論点です。前者を扱う LETTER*12 や SID の生成と dense retrieval を組み合わせる COBRA*13 は SID 型生成リトリーバルをさらに掘り下げる際の参考になるでしょう。
3.4 行動系列を系列変換として扱う生成型推薦
SID 型生成リトリーバルでは主に巨大なアイテム空間をどのトークンで表現して出力するかを扱うのに対し、この系統は長いユーザー行動履歴を系列としてどのようにモデル化し、学習と計算資源をどのように推薦性能へ結び付けるかに焦点を当てています。
何を「生成」するのか
たとえば、あるユーザーが 動画Aを表示 → 動画Aを最後まで視聴 → 動画Bに「いいね」 → 動画Cをスキップ という行動系列を持つ場合、従来の識別型推薦では履歴やユーザー属性を特徴量へ集約し、推薦候補となっている動画ごとにクリック率・視聴確率などのスコアを計算します。
これに対して大規模行動系列モデルでは表示された動画、その動画に対する反応、時刻、作者、ユーザー属性といった情報を時系列に沿った一つのトークン列として扱います。そしてある時点までの列を条件に、その後に起きる反応や次に正の反応を得る動画を予測します。
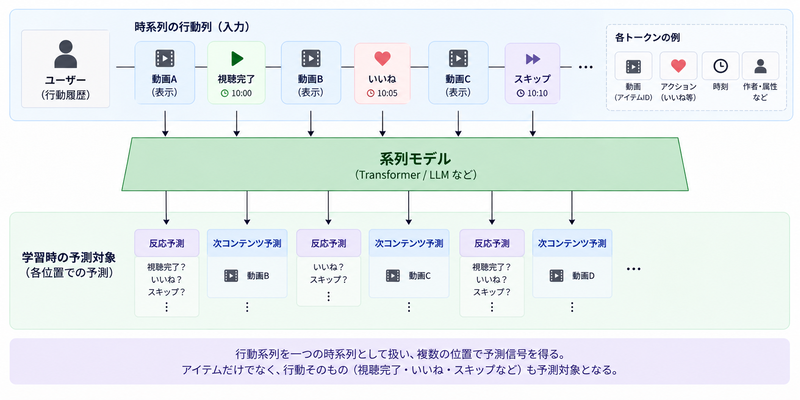
概念的には、時刻 までに観測された行動列
を条件として、次に起きる反応やコンテンツ
の確率を学習します。
出力は必ずしも次のアイテム IDだけではないのが特徴で、たとえば次のアイテム ID に対してクリック、いいね、スキップといったアクションを予測させることもあります。
このように、アイテム ID やアクションなど異なる種類のトークンを同じ時系列の変換問題として扱っており、「行動列の続きを条件付きで予測する」という定式化とそれを多くの時点で学習する方法がこの系統で生成型と呼ばれる理由です。
HSTU (ICML 2024)
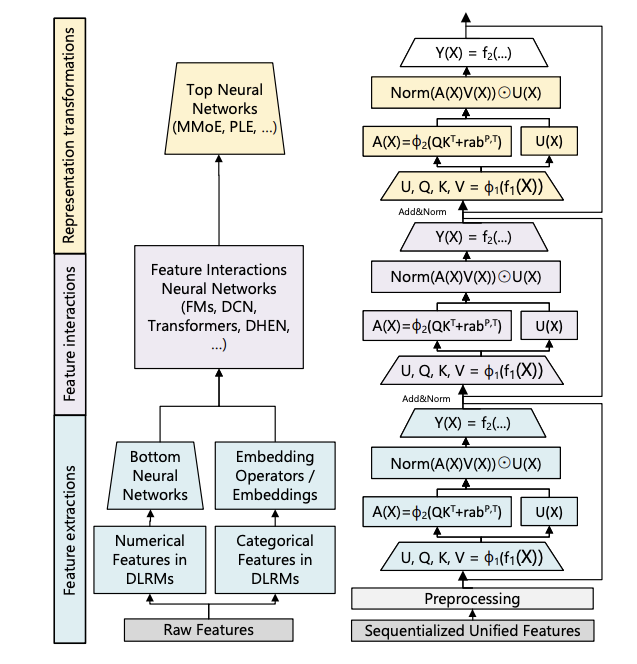
Meta の HSTU では、画像や動画などのコンテンツに対する視聴・スキップ・いいね・シェアといった行動をモデル化し、次に正の反応を得るコンテンツの予測(retrieval)と、提示された対象コンテンツに対する行動の予測(ranking)を系列変換タスクとして定式化しています。ポイントになるのは、カテゴリ特徴を系列データの一部として組み込み、十分な系列長・表現力・target-aware な定式化によって、手作業で作る数値集計特徴への依存を減らすことを狙っている点です。
例えばユーザーの行動ログが以下のようになっていたとします。
10:00 動画Aを視聴
10:02 動画Aの視聴完了
10:10 クリエイターXをフォロー
10:13 動画Bをスキップ
10:14 動画Cを視聴・いいね
これを以下のような系列データに落とし込みます。
[language:ja]
[city:tokyo]
10:00 [video:A] [action:watch]
10:02 [video:A] [action:complete]
10:10 [creator:X] [action:follow]
10:13 [video:B] [action:watch] [action:skip]
10:14 [video:C] [action:watch] [action:like]
系列の冒頭には [language:ja]、[city:tokyo] というユーザーの使用言語と居住地に関するメタデータの情報が挿入されています。このような変化頻度の低いカテゴリ特徴は値が変わった時だけイベントとして挿入します。一方で、頻繁に変化するカウンタや比率のような数値特徴をすべて逐次的に計算して挿入することは計算量や保存量の面から現実的ではありません。そのため HSTU では行動・カテゴリ特徴を一つの系列として扱い、非常に長い履歴を大規模モデルで学習することで、CTR のような手作業の集計特徴への依存を減らすことを目指します。
論文で提案されている HSTU(Hierarchical Sequential Transduction Unit)は、このような長く、語彙が大きく、時間とともに分布が変化する系列を処理するための encoder です。アテンションやメモリ使用量を推薦用に最適化し、長い系列を Transformer より効率的に扱うことを狙っています。論文では数千トークンの系列での効率とオンライン A/B テストでの改善に加え、HSTU を用いた Generative Recommender が大規模ストリーミング設定で計算量に対してべき乗則的に品質を伸ばす傾向も示しています。
この結果は推薦でもモデル・データ・計算量を増やして性能を伸ばす余地があることを示唆します。
OneRec (2025)
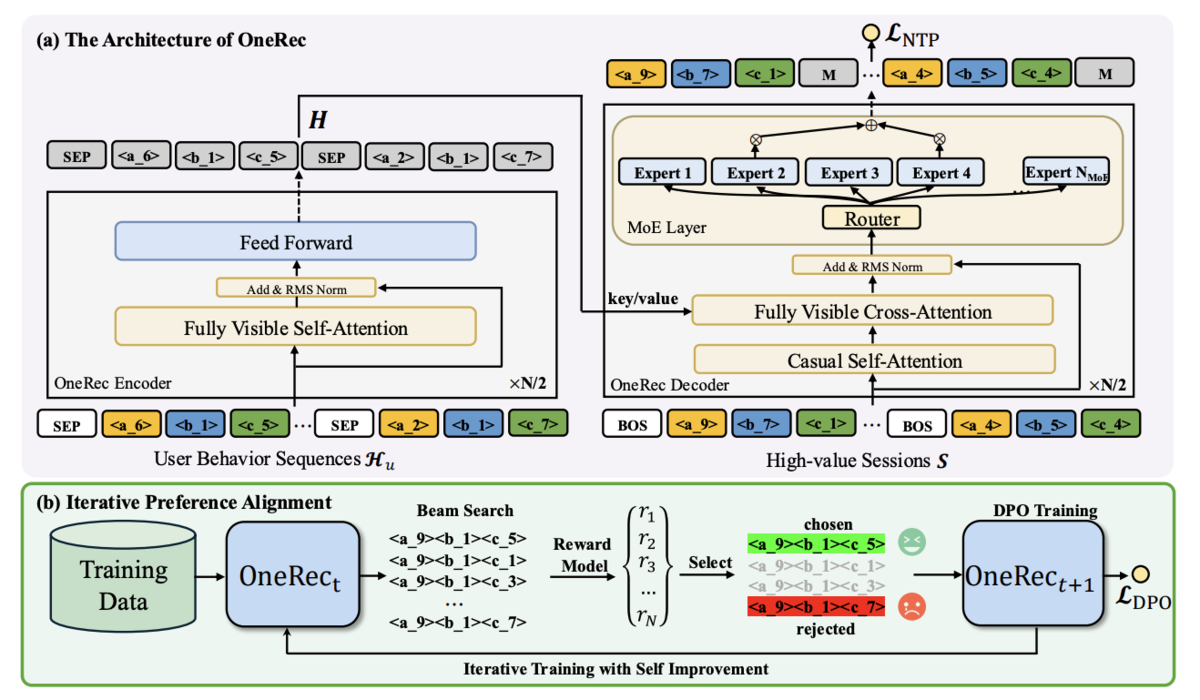
快手の OneRec は候補抽出・ランキングのように複数の段階に分かれた推薦パイプラインを、encoder-decoder による一つの生成型推薦システムとして組み直すものです。OneRec では次アイテムを一件ずつ生成するのではなく、ユーザー履歴から一つの推薦セッションを構成する複数動画の Semantic ID を自己回帰的に生成します。生成の単位を単一のアイテムから推薦リストへ広げつつ、候補抽出とランキングに分かれた多段パイプラインを単一の生成モデルで直接最適化しようとする点が特徴です。
OneRec も動画を Semantic ID で表現しており、その点だけを見れば 3.3 の SID 型生成リトリーバルと重なります。ただし、TIGER や PLUM が次の一件を得るために SID を生成するのに対し、OneRec は一つのセッションを構成する複数動画の SID を生成します。
OneRec では decoder で Sparse MoE を用いてモデル容量を拡張しつつ、生成した複数の推薦リストを外部の報酬モデルで評価します。評価が最も高いリストと低いリストから選好データを作り、NTP(Next Token Prediction)損失と DPO(Direct Preference Optimization)損失を組み合わせて decoder を学習します。 こうした「Sparse MoE でモデル容量を拡張する」「生成モデルの出力を外部評価に基づいてアライメントする」という構造は、LLM のスケーリングや post-training で発展してきた知見を、推薦の生成モデルへ応用したもの と捉えられます。
論文では、快手のメイン画面の動画推薦で既存の多段推薦システムと比較したオンライン A/B テストを行い、OneRec-1B+IPA は総視聴時間を +1.68%、平均視聴時間を +6.56% 改善したと報告しています。また、0.05B から 1B へのモデル拡大で性能が一貫して改善する傾向も示しています。
OneRec が生成しているものは SID 型リトリーバルと同じく動画を表す Semantic ID ですが、LLM の発展で培われた設計を推薦タスクに取り込んでいる点に OneRec の面白さがあります。
HSTU と OneRec ではともにモデル規模の拡大に伴って性能が改善する傾向を報告しており、これは LLM で観測されてきたスケーリングの性質が推薦でも得られる可能性を示す興味深い結果です。ただし、まだ推薦タスク全般で成り立つ法則とまでは言えない点に注意が必要です。
3.5 LLM ベース推薦ランカー
LLM を推薦システムへ用いていれば生成型推薦、というわけではありません。ここでは LLM を使ったランカーモデル(LLM ベース推薦ランカー)を生成型推薦と対比させます。
本記事で扱う LLM ベース推薦ランカーでは、ユーザー履歴、現在の文脈、候補アイテムの情報を LLM に与え、既知の候補集合にスコア付けをして並べ替えます。後述する GenRec のように文脈表現をランキングヘッドへ渡す方式もあれば、LlamaRec のように候補インデックスのトークン確率を候補スコアとして読む方式もあります。いずれも推薦の出力は既知の候補に対するスコアであり、推論上の役割は識別型推薦のランカーと同じです。
このように事前学習された decoder-only LLM を基盤にしていても、それだけで推薦の出力が生成的になるわけではありません。ここで中心となる問いは、「従来は特徴量として与えていた情報をどのように文脈として構成し、事前学習済み LLM の表現能力をランキングへ結び付けるか」 です。この対比は、「LLM を使うこと」と「推薦対象を生成すること」を分けて考えるために重要です。
LlamaRec (PGAI@CIKM 2023)
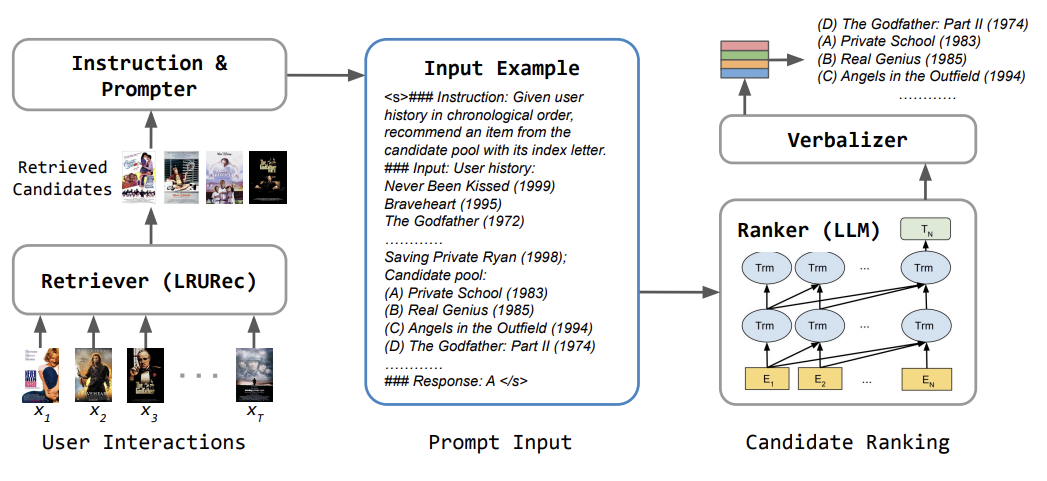
LlamaRec は two-stage recommender のランキング部分に LLM を使うわかりやすい例です。まず軽量な系列推薦モデルで候補を取り出し、ユーザー履歴と候補アイテムのタイトルをテキストとして LLM に入力します。入力テキストの構成として、候補ごとに (A)、(B)、(C) のようなインデックスを割り当て、LLM にはそのインデックスを一つ出力するよう学習させます。例えば正解が候補 (B) であれば、教師ラベルはアイテム名ではなく "B" となります。
応答位置における語彙全体の logits を 、候補アイテム
に対応するインデックス文字を
とします。verbalizer は
から候補インデックスの logits だけを取り出し、候補集合
の中で正規化します。
この確率で候補を並べ替えるため、言語モデルの次トークン分布を候補のスコアベクトルとして読み出していることになります。推論時に必要なのは一回の forward pass と候補インデックスの logits の取得だけであり、アイテム名や推薦リストを逐次デコードしたりビーム探索したりする必要はありません。
ベースモデルには事前学習済みの Llama 2 7B を用いており、PLUM のように推薦データで継続事前学習を行うのではなく、既存の Llama 2 をランキングタスクへ直接適応する構成になっています。
GenRec (2026)
論文: Li et al., "GenRec: An LLM-Backed Recommendation Ranker at Netflix", arXiv:2608.10257, 2026
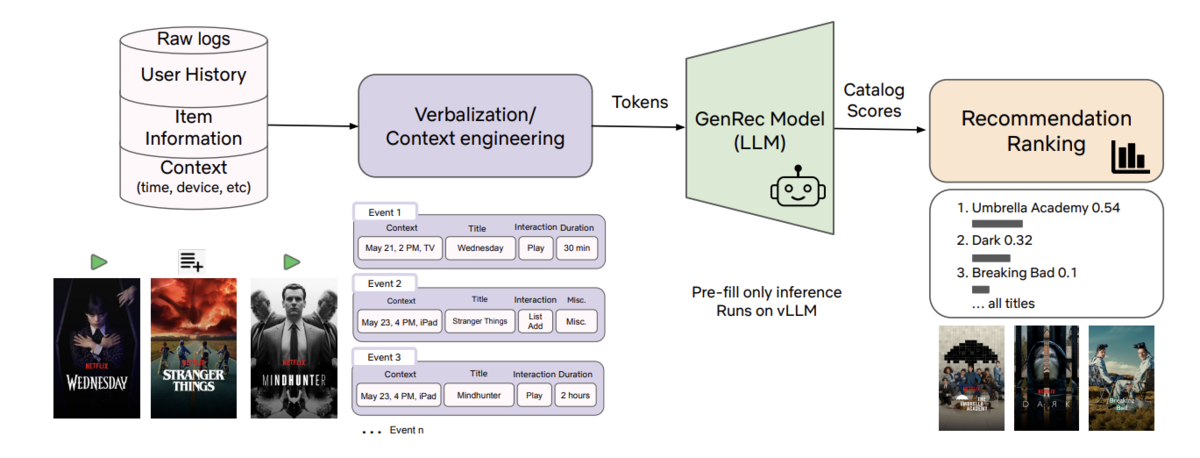
Netflix の GenRec は、LLM ベース推薦ランカーを大規模カタログのランキングへ適用した例です。Netflix のデータを学習した decoder-only Transformer へ、会員の視聴履歴、デバイスや時刻などの文脈、作品メタデータを文章として与えます。
ここで重要なのは context engineering の観点で、プロンプトとして与えるコンテキストの中でどの行動をどのように記述し、作品情報はどこまで詳しく記述するか、といった設計がモデル品質とコストを大きく左右します。例として、context engineering によって構成する入力の概念を以下に示します。
Member profile:
- Country: Japan
- Plan: Standard
- Member since: 2023-04

Current context:
- Surface: Home
- Device: TV
- Local time: Friday evening

Recent high-signal history:
- Completed "3 Body Problem" (51 minutes).
- Gave a thumbs-up to "Stranger Things".
- Watched "Black Mirror" for 43 minutes.

Compressed history:
- Watched several episodes of a science-fiction series over the past three days.
- Often watches suspense and science-fiction titles.

Item detail to emphasize:
- "New science-fiction drama X": released this week; genre: science fiction; synopsis: ...

Task:
- Predict the next items that the user will play or thumb up.
この例では長時間視聴や高評価のような強いシグナルを個別に残す(例: Gave a thumbs-up to "Stranger Things".)一方で、繰り返し視聴したエピソード群は要約(例: Watched several episodes of a science-fiction series over the past three days.)しています。また、新作など重要な作品にはジャンルやあらすじを補います。どの情報を残すかは単に入力を短くするためではなく、LLM に「ユーザー表現として重要な情報は何か」と「推薦文脈として何を与えるか」を決める設計です。
GenRec は入力となるテキストを decoder-only Transformer で処理し、pooling 位置の隠れ状態を文脈表現 として利用します。これとアイテムごとの埋め込み
をランキングヘッド
へ渡し、各アイテムのスコア
を計算します。
LLM がユーザーの履歴と文脈を表す を作り、ランキングヘッドが既知カタログを評価するという役割分担になっており、学習時は LLM 本体とランキングヘッド、アイテム埋め込みは全て end-to-end で学習されます。
推論時は prefill-only で を得て、catalog-aware なランキングヘッドでカタログまたは候補集合をスコアリングします。このように、GenRec では decoder-only Transformer を prefill-only で使うことでスループットとレイテンシのボトルネックになる decode 部分の実行を避けています。
GenRec が向き合うのは 「数千もの手設計特徴や複雑な特徴交差を持つ従来のランカーを、LLM が読む文脈と推薦向けの事後学習でどこまで置き換えられるか」 という課題です。論文では大規模なオンライン A/B テストで既存の本番ランカーを上回る改善を報告していますが、これは提示された候補集合を評価するランキングシステムとしての結果であり、生成型推薦としての結果ではありません。
Netflix は GenRec を "LLM-Backed Recommendation Ranker" と位置付けており、生成型推薦とは呼んでいません。本稿でも LLM ベース推薦ランカーを狭い意味での生成型推薦に含めず、SID 型生成リトリーバルや行動系列モデルとの違いを確認する対比対象として扱いました。
4. 「LLM から直接推薦結果を得る」ために
近年では目まぐるしいスピードで生成 AI の性能が改善しているため、「汎用チャット LLM にユーザーの情報を渡しておすすめアイテムを直接尋ねればよいのではないか」 という自然な発想が出てきます。
LLM に直接アイテムを出力させること自体は、専用に学習・制約した生成型推薦モデルで実現でき、SID 型生成リトリーバルや OneRec はその実装例です。
しかし、汎用チャット LLM へ「おすすめアイテムを教えて」と問いかけるだけでは大規模な推薦システムに必要な機能と性能を満たせません。チャット LLM を推薦機能の中心に置くには生成速度、カタログの正確性、履歴に基づくパーソナライズ、事業上の最適化ターゲットの要求を満たす必要があります。
| 実現したいこと | そのままでは起きる問題 | 必要な仕組み |
|---|---|---|
| 十分な生成速度 | decoder-only LLM で prefill → decode をするとレイテンシとスループットのボトルネックになる | ・出力コードを短くし、探索幅を制御する ・GenRec のように decode を行わない採点型ランカーを選ぶ |
| カタログ内のアイテムのみを出す | カタログ外のアイテムやポリシーに合わないアイテムを出力してしまう | ・Semantic ID やアイテム ID を出力単位にして実在するコード列だけを探索する ・生成後の post-filtering でポリシーの制約を適用する |
| ユーザーの嗜好に合わせる | アイテム同士の協調信号や短期的な関心に基づくパーソナライズが行えない | ・行動ログとカタログ情報で事前/事後学習し、推薦タスクに適したトークン化、教師信号、オンライン評価を設計する |
| サービスや機能の目的に合わせた最適化 | 短期的な関連度だけでなくGMV、広告、割引率、在庫など複数の目的と制約を考慮した推薦リストが作れない | ・損失の重み付け、報酬モデル、選好最適化、再ランキングや制約フィルタを組み合わせ、サービスの目的へ整合させる |
要件をすべて一つの LLM に担わせる必要はありません。たとえば候補のパーソナライズを軽量ランカーに任せたり、生成結果をカタログ内のアイテムで絞り込み・サービスポリシーに応じたアイテム除外をする構成も現実的です。生成型推薦は、こうした要件のうちどこまでを生成モデルに担わせるかを設計する試みと捉えられます。
5. おわりに
本記事では生成型推薦と呼ばれる手法として、生成型リトリーバルと行動系列をモデリングするものをいくつか紹介しました。
生成型かどうかを分ける要点は LLM を使うことそのものではなく、候補を個別採点する代わりに何を出力として直接構成・予測するかにあります。SID 型は巨大カタログの出力表現を、行動系列モデルは長い履歴の表現と学習信号を主な論点にします。
一方、LLM ベース推薦ランカーは LLM を用いていますが、候補集合に対するスコアがアウトプットであるという点では従来の識別型手法と同様です。
次回は、(気力が持てば)SID型生成リトリーバルに焦点を絞っていくつか文献紹介と実行例を示そうと思います。
*1:Hou et al., A Survey on Generative Recommendation: Data, Model, and Tasks, 2025
*2:Rajput et al., Recommender Systems with Generative Retrieval, NeurIPS 2023
*3:Li et al., Tutorial on Generative Recommendation: Foundations and Frontiers, KDD 2026
*4:Rajput et al., Recommender Systems with Generative Retrieval, NeurIPS 2023
*5:He et al., PLUM: Adapting Pre-trained Language Models for Industrial-scale Generative Recommendations, WWW 2026
*6:Zhai et al., Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations, ICML 2024
*7:Deng et al., OneRec: Unifying Retrieve and Rank with Generative Recommender and Iterative Preference Alignment, arXiv:2502.18965, 2025
*8:Yue et al., LlamaRec: Two-Stage Recommendation using Large Language Models for Ranking, PGAI@CIKM 2023
*9:Li et al., GenRec: An LLM-Backed Recommendation Ranker at Netflix, arXiv:2608.10257, 2026
*10:Lee et al., Autoregressive Image Generation Using Residual Quantization, CVPR 2022
*11:Ju et al., Generative Recommendation with Semantic IDs: A Practitioner's Handbook, arXiv:2507.22224, 2025
*12:Wang et al., Learnable Item Tokenization for Generative Recommendation, CIKM 2024
*13:Yang et al., Sparse Meets Dense: Unified Generative Recommendations with Cascaded Sparse-Dense Representations, arXiv:2503.02453, 2025